Za głośny dźwięk zwykle ginie w przesterowaniu, a prototyp z Londynu potrafi go odtworzyć
Szept i huk mają w cyfrowym świecie ten sam problem. Żeby nagrać cichy dźwięk, przetwornik musi rozróżniać bardzo drobne zmiany sygnału. Żeby nagrać głośny, musi mieć zapas na duże wychylenia. Przy stałej liczbie bitów jedno odbywa się kosztem drugiego. Inżynierowie żyją z tym kompromisem od blisko 90 lat, od czasu, gdy Brytyjczyk Alec Reeves opatentował w 1937 roku modulację impulsowo-kodową, czyli sposób zapisywania dźwięku liczbami.
Badacze z Imperial College London pokazali, że ten kompromis da się obejść bez dokładania bitów. Ruiming Guo, Yuliang Zhu i Ayush Bhandari opisali w czasopiśmie IEEE Transactions on Audio, Speech and Language Processing system o nazwie USF-Audio. Zamiast obcinać za głośny sygnał, układ celowo go „zawija” do wąskiego zakresu, a dopiero potem zamienia na liczby. Algorytm odtwarza z tego pierwotny przebieg. W prototypie, który zapisywał tylko sześć bitów na próbkę, zakres dynamiki wzrósł o co najmniej 18 decybeli w porównaniu ze zwykłym sześciobitowym przetwornikiem.
Skąd się wziął kompromis
Każdy mikrofon w telefonie, dyktafonie czy cyfrowym stetoskopie wytwarza sygnał elektryczny, który zmienia się w sposób ciągły. Komputer potrzebuje jednak liczb. Tę zamianę wykonuje przetwornik analogowo-cyfrowy. Kilkadziesiąt tysięcy razy na sekundę mierzy napięcie i przypisuje mu jeden z dostępnych poziomów.
Liczba poziomów zależy od liczby bitów. Sześć bitów daje 64 poziomy, szesnaście – jak na płycie CD – daje ich 65 536. Przetwornik ma przy tym sztywne granice. Jeśli ustawi się je szeroko, żeby zmieścić huk, sąsiednie poziomy leżą daleko od siebie i cichy szept wpada między nie. Jeśli ustawi się je wąsko, szept wyjdzie ładnie, ale huk przekroczy górną granicę.
Wtedy dochodzi do przesterowania, które inżynierowie nazywają obcinaniem. Przetwornik ścina szczyty fali na płasko i przez chwilę zapisuje stale tę samą, największą wartość. Każdy, kto słyszał nagranie z koncertu zrobione telefonem tuż przy głośniku, zna ten chrapliwy, płaski dźwięk. Oprogramowanie może potem próbować zgadnąć, jak wyglądały ścięte szczyty, ale tej informacji w zapisie już nie ma.
Inżynierowie radzą sobie na dwa sposoby. Dokładają bitów, co podnosi koszt, rozmiar i pobór prądu układu. Albo stosują automatyczną regulację wzmocnienia, która ścisza sygnał, gdy robi się głośno. To z kolei zmienia proporcje dźwięku i nie zawsze nadąża za nagłym hałasem. W obu przypadkach obowiązuje zasada, którą sformułowali Reeves, a później Claude Shannon, twórca matematycznej teorii komunikacji: przetwornik dostaje sygnał taki, jaki jest, i ma go zapisać.
Wskazówki zegara zamiast ściany
Zespół z Imperial College zadał inne pytanie. Skoro dzisiejsze komputery liczą szybko i tanio, czy sygnał musi trafiać do przetwornika w tej samej postaci co przed 90 laty?
Pomysł najłatwiej porównać do zegara. Wskazówka minutowa po pełnym obrocie nie zatrzymuje się na dwunastce, tylko zaczyna kolejne okrążenie. Z samej jej pozycji nie wiadomo, która jest godzina, ale jeśli ktoś patrzy na zegar co chwilę, łatwo policzy, ile razy wskazówka przeszła przez dwunastkę. Matematycy nazywają takie zawijanie operacją modulo.
USF-Audio robi to samo z napięciem. Gdy sygnał dochodzi do górnej granicy przetwornika, układ analogowy przed przetwornikiem „przerzuca” go na dolną granicę, i odwrotnie. Zamiast płaskiego, ściętego szczytu powstaje przebieg, który kilka razy przeskakuje między granicami. Na wykresie wygląda to jak poszarpana piła, a w słuchawkach jak zakłócenia.
W tym poszarpaniu jest jednak porządek. Przeskoki mają zawsze tę samą wysokość, równą szerokości zakresu przetwornika. Jeśli próbki leżą dostatecznie gęsto, algorytm potrafi wskazać miejsca, w których układ zawinął sygnał, i dodać brakujące odcinki z powrotem. Z poszarpanej piły odtwarza gładką falę o amplitudzie kilka razy większej niż zakres samego przetwornika.
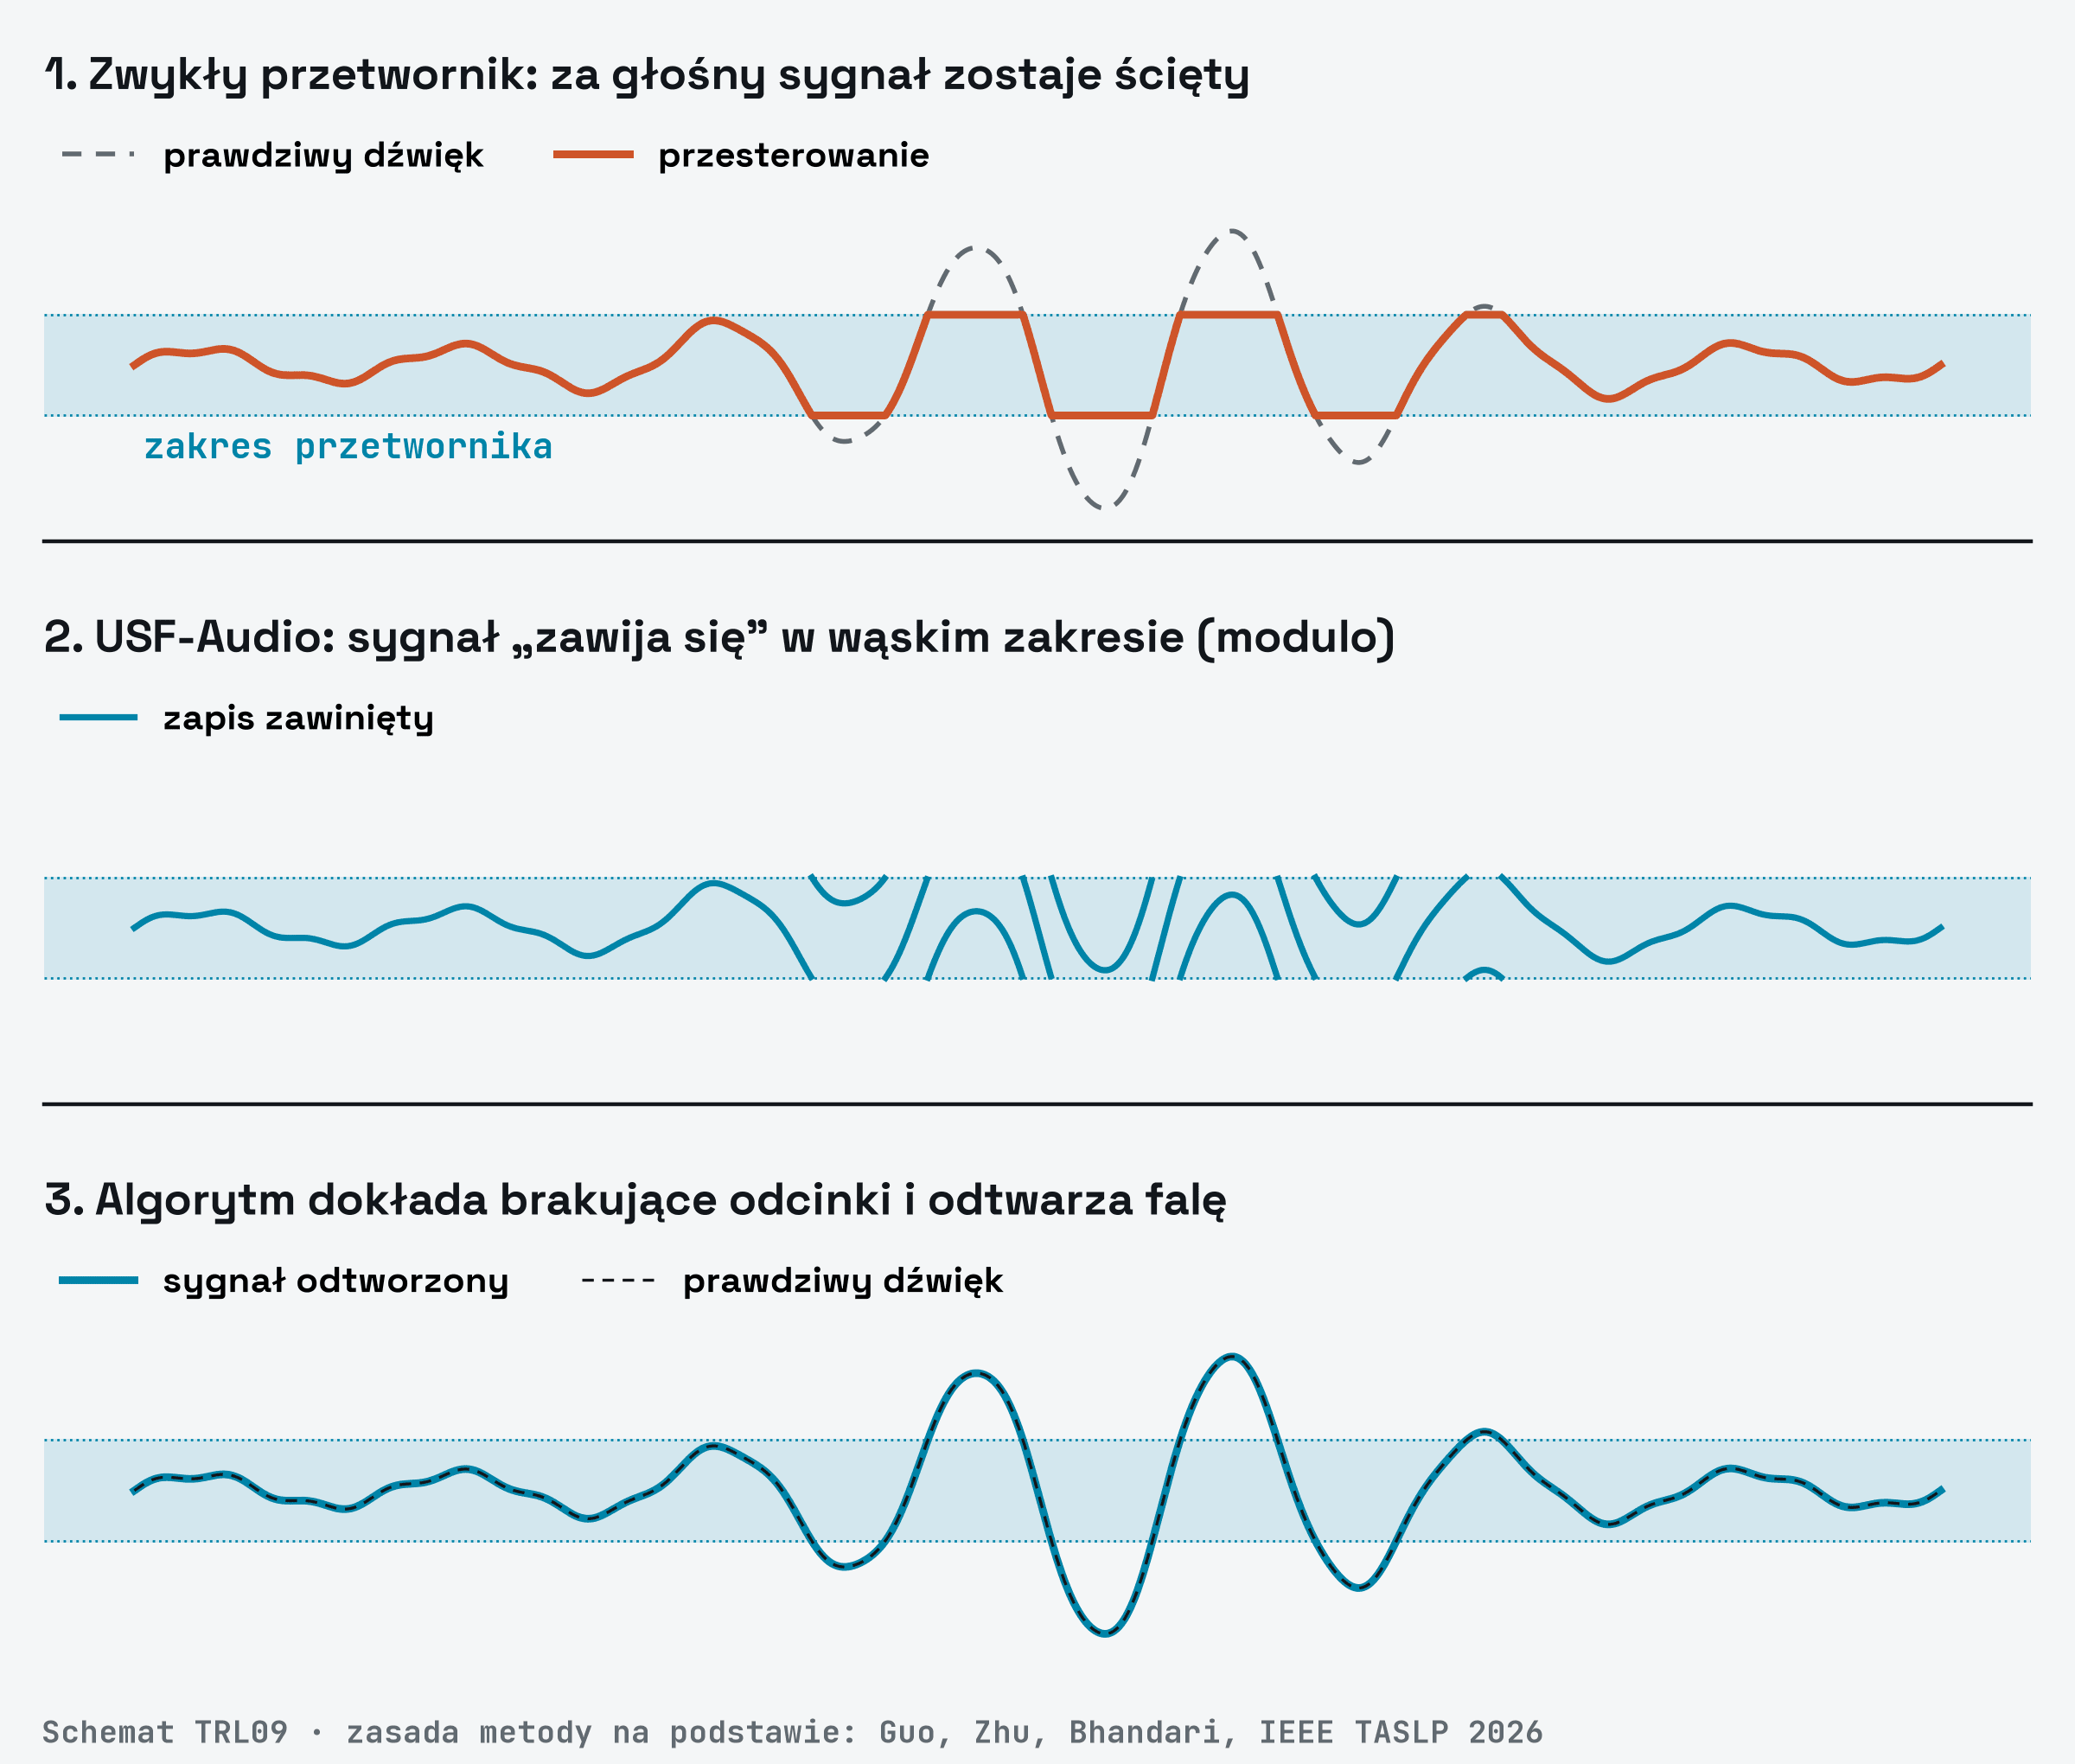
Rys. 1. Zwykły przetwornik ścina szczyty za głośnego dźwięku (u góry). USF-Audio zawija sygnał w wąskim zakresie (w środku), a algorytm dokłada brakujące odcinki i odtwarza pełną falę (na dole). Schemat TRL09 na podstawie zasady opisanej w: Guo, Zhu, Bhandari, IEEE TASLP 2026.
Teorię tego podejścia Bhandari rozwija od kilku lat. W pracy z 2021 roku w IEEE Transactions on Signal Processing, napisanej wspólnie z Felixem Krahmerem i Rameshem Raskarem, opisał warunki, przy których zawinięty sygnał da się jednoznacznie odtworzyć. Grupa nazywa całą rodzinę metod Unlimited Sensing, czyli „pomiar bez ograniczeń”. Nowa publikacja przenosi te pomysły do dźwięku i dokłada do nich działający sprzęt.
Od wzoru do mikrofonu
Autorzy połączyli trzy elementy: matematyczne gwarancje odtworzenia, algorytmy, które radzą sobie z długimi nagraniami audio, oraz kompletny tor od mikrofonu do zapisu cyfrowego. Przetwornik zbudowali z gotowych, dostępnych w handlu podzespołów elektronicznych. Nie potrzebowali do tego specjalnego chipu ani fabryki półprzewodników.
„Reeves i Shannon stworzyli idee, dzięki którym możliwa stała się komunikacja cyfrowa. Te idee nie są błędne. Zmieniło się to, że współczesne obliczenia pozwalają zapytać, czy sygnał analogowy wciąż musi trafiać do przetwornika w ten sam sposób” – mówi Ruiming Guo, pierwszy autor pracy i pracownik naukowy Wydziału Elektrotechniki i Elektroniki Imperial College.
Układ sprawdzono na prawdziwych nagraniach: mowie, muzyce, tonach serca i głosach zwierząt. To dobór nieprzypadkowy. Każdy z tych sygnałów łączy ciche szczegóły z nagłymi, głośnymi fragmentami.
Co pokazały liczby
Najważniejszy wynik dotyczy zakresu dynamiki, czyli stosunku najgłośniejszego dźwięku, jaki da się zapisać, do najcichszego. Przy sześciu bitach na próbkę USF-Audio zyskał co najmniej 18 decybeli względem zwykłego sześciobitowego przetwornika. Według autorów odpowiada to mniej więcej ośmiokrotnie szerszemu zakresowi amplitud, który mieści się w tej samej liczbie bitów.
Dla porównania: w klasycznym przetworniku każdy dodatkowy bit poszerza zakres dynamiki o około 6 decybeli. Zysk rzędu 18 decybeli to więc w przybliżeniu tyle, co trzy bity więcej – bez zmiany samego przetwornika.
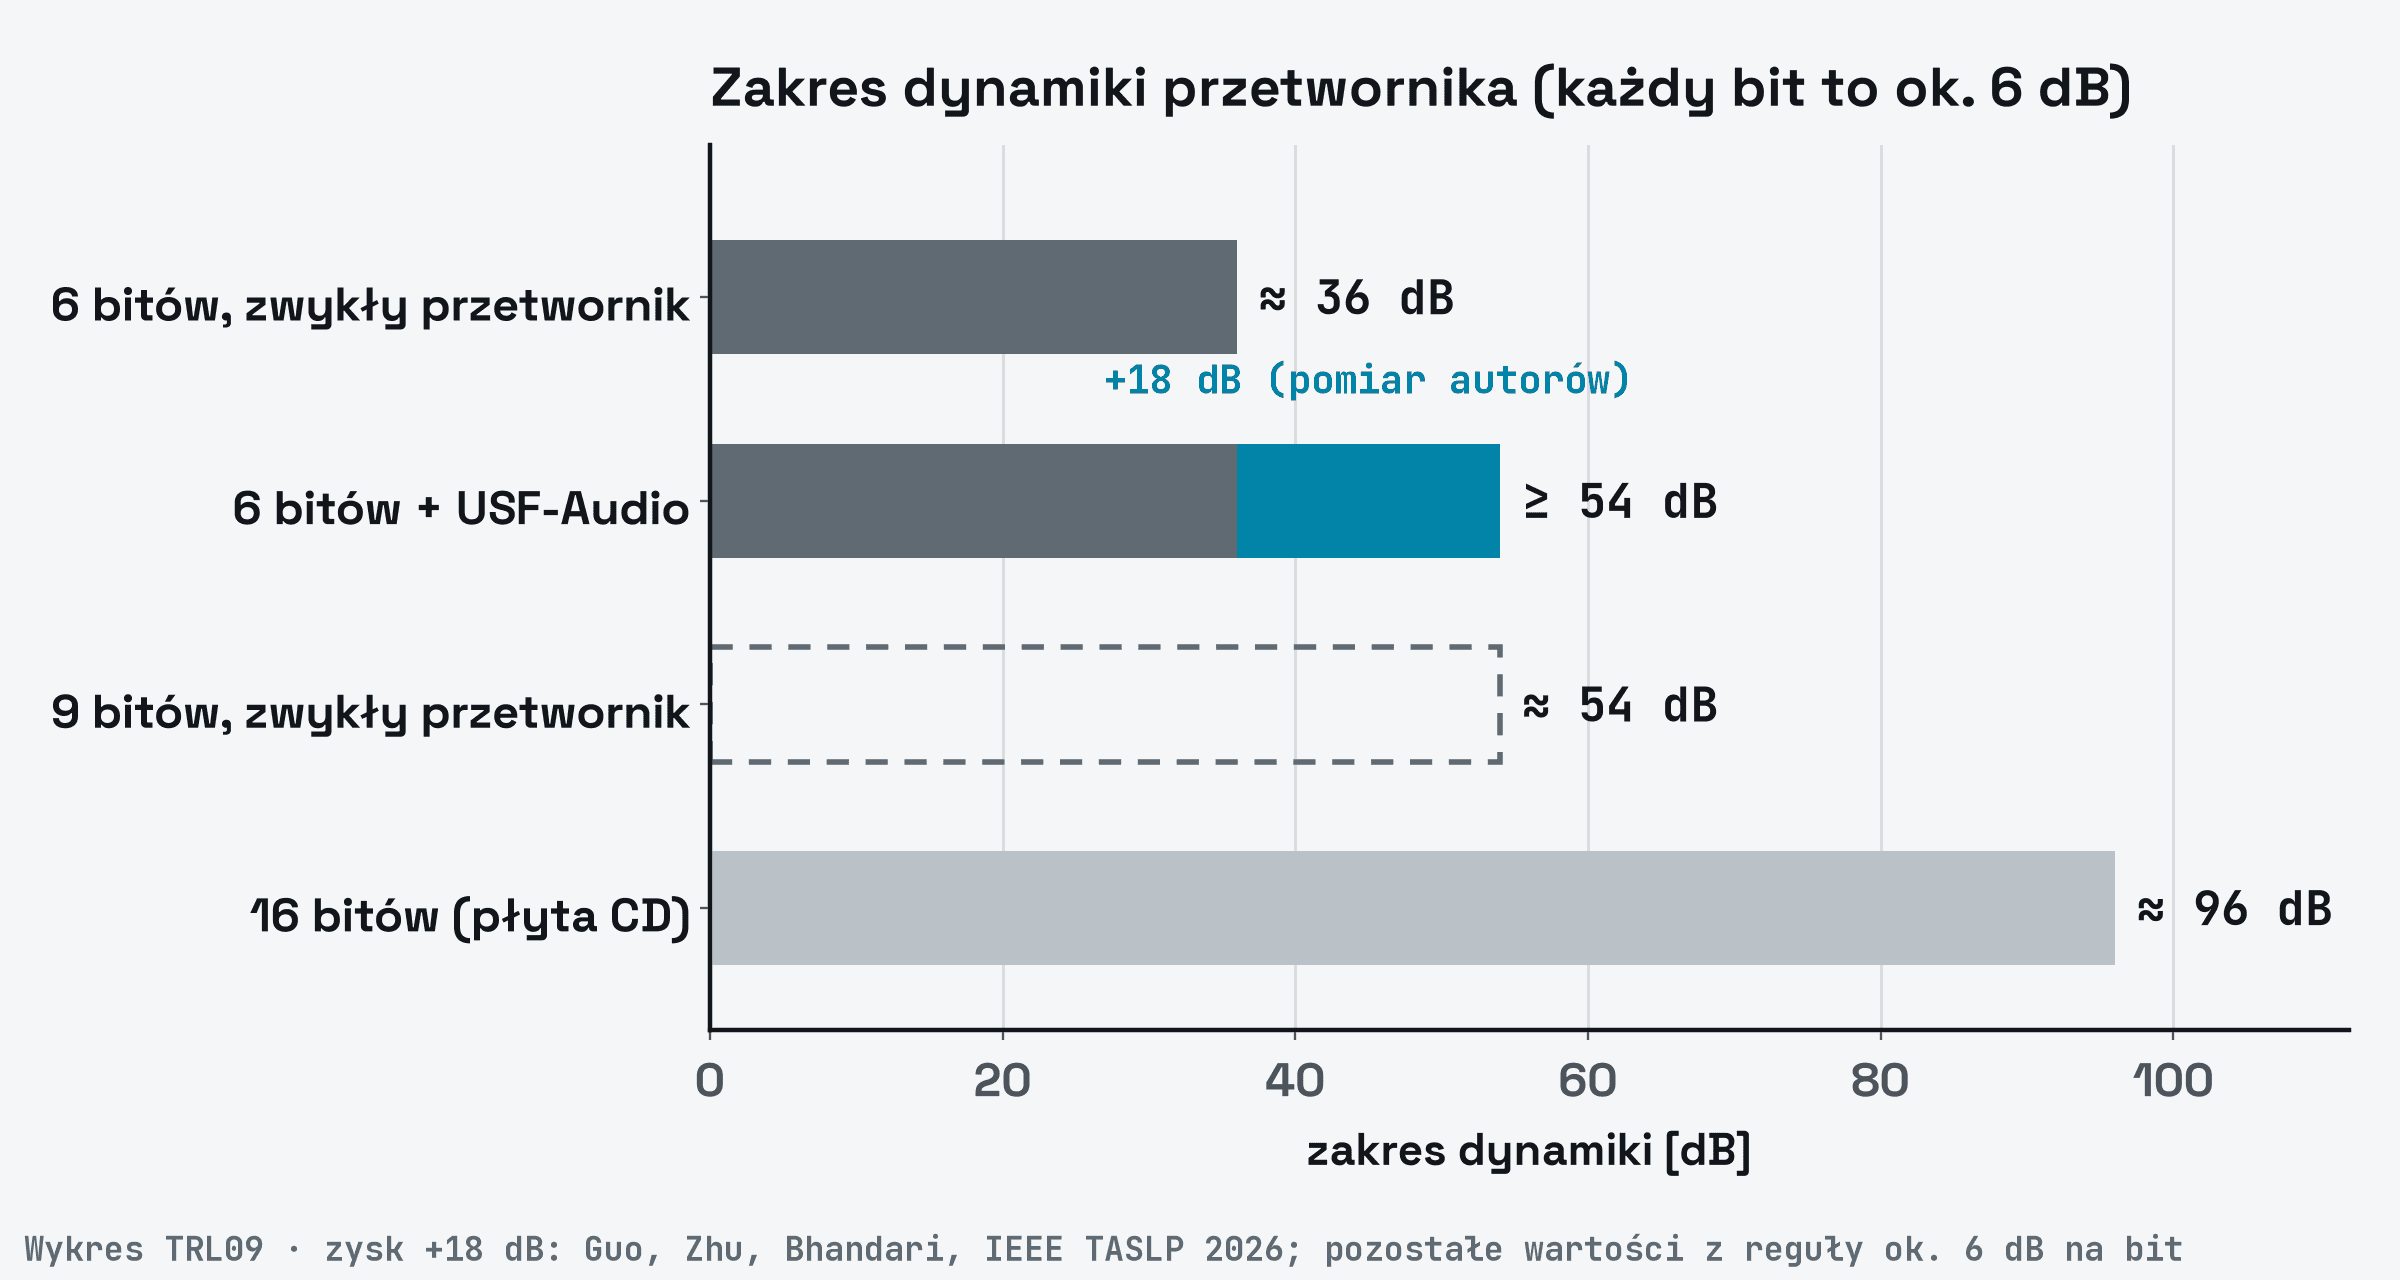
Rys. 2. Każdy bit przetwornika dodaje ok. 6 dB zakresu dynamiki. Zmierzony zysk USF-Audio, co najmniej 18 dB przy sześciu bitach, odpowiada mniej więcej trzem dodatkowym bitom. Wykres TRL09; zysk +18 dB za: Guo, Zhu, Bhandari, IEEE TASLP 2026, pozostałe wartości z reguły ok. 6 dB na bit.
Sześć bitów to bardzo mało. Taka rozdzielczość daje dźwięk wyraźnie gorszy od płyty CD i nikt nie nagrywa w niej muzyki do słuchania. Badacze wybrali ją celowo. Przy niskiej rozdzielczości różnice między metodami słychać najlepiej, a właśnie tanie, oszczędne przetworniki o małej liczbie bitów trafiają do czujników i urządzeń noszonych na ciele.
Czy ludzie to słyszą
Decybele na wykresie to jedno, a ucho to drugie. Zespół sprawdził to więc w kontrolowanym teście odsłuchowym z udziałem 52 osób. Uczestnicy oceniali dźwięk odtworzony metodą Unlimited Sensing, zwykły zapis sześciobitowy oraz zapis ze ściętymi szczytami.
Odtworzony dźwięk z USF-Audio dostał wyższe oceny niż oba pozostałe warianty. Autorzy podkreślają, że korzyść nie kończy się na teorii ani na pomiarach laboratoryjnych. Inny sposób zapisu sygnału daje poprawę, którą ludzie słyszą.
„Wielka muzyka żyje kontrastami, od najcichszego szeptu po najgłośniejsze crescendo. Konwencjonalne nagrywanie cyfrowe wymusza jednak kompromisy między tymi skrajnościami. Zadaliśmy zupełnie inne pytanie: co, jeśli zmienimy to, co reprezentują bity, zamiast po prostu dokładać ich więcej?” – mówi Ayush Bhandari, profesor nadzwyczajny na tym samym wydziale i współautor pracy.
Stetoskop, las i sztuczna inteligencja
Muzyka jest najbardziej efektowną ilustracją, ale autorzy wskazują zastosowania, w których zysk może być większy. Cyfrowy stetoskop musi wyłapać słabe szmery serca lub oddechu, a jednocześnie nie może się przesterować, gdy lekarz poruszy głowicą albo pacjent zakaszle. Czujnik ustawiony w lesie ma odróżnić ciche wołanie ptaka od przejeżdżającej ciężarówki czy szumu deszczu. W obu przypadkach słaby sygnał trzeba zachować obok silnego.
Cyfrowe stetoskopy i domowe urządzenia do osłuchiwania, których nagrania oceniają algorytmy, rozwijają także europejskie firmy, w tym poznańska StethoMe. Nie ma ona związku z opisywaną pracą, ale dobrze pokazuje rynek, na który taka technika mogłaby trafić: urządzenia małe, zasilane z baterii, w których każdy dodatkowy bit przetwornika kosztuje prąd i miejsce na płytce.
Badacze zwracają też uwagę na sztuczną inteligencję. Coraz więcej systemów uczy się rozpoznawać świat na podstawie danych z mikrofonów i czujników. Algorytm nie odzyska jednak informacji, której przetwornik nie zapisał. Jeśli przetwornik ściął szczyt sygnału, nawet najmocniejszy model może go najwyżej zgadywać. Unlimited Sensing proponuje zachować tę informację już przy zapisie, zamiast później łatać braki.
Czego jeszcze nie wiadomo
Autorzy sami zaznaczają, że część korzyści to na razie obietnica. Mniejsza liczba bitów może oznaczać mniejsze i oszczędniejsze układy, ale tego zespół w prawdziwym urządzeniu jeszcze nie wykazał. Układ zawijający napięcie i algorytm odtwarzający sygnał też potrzebują energii. Dopiero inżynierski prototyp, na przykład stetoskopu albo czujnika środowiskowego, pokaże, czy bilans wychodzi na plus.
Otwarte pozostaje także pytanie o pracę w czasie rzeczywistym. Telefon czy aparat słuchowy muszą przetwarzać dźwięk na bieżąco, z bardzo małym opóźnieniem. Z udostępnionych materiałów nie wynika, jak szybko działa algorytm na typowym, energooszczędnym procesorze. Nie wiadomo również, jak metoda zachowa się przy szumie i zakłóceniach elektrycznych, które w tanich urządzeniach są codziennością.
Wreszcie przetwornik zbudowany z gotowych podzespołów to dowód, że pomysł działa, a nie produkt. W skali gotowości technologicznej USF-Audio zajmuje szczebel 3–4: koncepcja sprawdzona w laboratorium na prawdziwych sygnałach, z działającym prototypem toru pomiarowego. Do zintegrowanego układu scalonego, który producent mikrofonów mógłby wstawić do słuchawek, droga jest jeszcze długa.
Historia zatacza koło
Praca ma też wymiar symboliczny. Alec Reeves był absolwentem Imperial College, a jego wynalazek z 1937 roku stał się podstawą cyfrowej telefonii, płyt CD i plików muzycznych. Prawie 90 lat później naukowcy z tej samej uczelni pokazują, że jedno z założeń leżących u podstaw jego metody nie musi już obowiązywać.
Nie chodzi przy tym o obalenie Reevesa ani Shannona. Ich prawa wciąż działają. Zmieniło się otoczenie: obliczenia, które w latach 30. były nie do pomyślenia, dziś wykonuje tani układ w zegarku. Skoro liczenie jest tańsze niż dodatkowe bity, opłaca się przenieść część pracy z przetwornika na algorytm. Wygląda na to, że granice cyfrowego zapisu zależą nie tylko od tego, ile bitów mamy do dyspozycji, ale też od tego, co te bity oznaczają.
Bibliografia
- Guo R., Zhu Y., Bhandari A. Re-thinking Digital Audio via Unlimited Sensing: Theory, Algorithms, and Hardware Validation. IEEE Transactions on Audio, Speech and Language Processing (2026). DOI: 10.1109/taslpro.2026.3739166
- Bhandari A., Krahmer F., Raskar R. On Unlimited Sampling and Reconstruction. IEEE Transactions on Signal Processing (2021). DOI: 10.1109/tsp.2020.3041955
- Shannon C. E. A Mathematical Theory of Communication. Bell System Technical Journal (1948). DOI: 10.1002/j.1538-7305.1948.tb01338.x
- Horrell J. (Imperial College London). Engineers challenge 90-year limitation in digital audio sensing. TechXplore (11.11.2026). techxplore.com
Komentarze· 0
Brak komentarzy. Dodaj pierwszy.